Karan Kumar
Full Stack Software Engineer che sviluppa prodotti integrati con l’AI e sistemi backend.
Chi Sono
Costruisco il livello tra l'AI e la produzione: dove i modelli incontrano utenti reali, dati reali e modalità di guasto reali. Ho sviluppato il backend di Brarista, uno strumento di fitting basato su AI per gli store Shopify, e ora sto costruendo da zero una pipeline RAG — Ollama, ChromaDB, chunking basato sulle frasi — perché preferisco capire il retrieval piuttosto che limitarmi a chiamare un'API.
Rilascio, e poi resto per assicurarmi che regga.
Luogo
FLORENCE_IT
Focus
BACKEND_LLM
Formazione
MSc, Univ. of Florence
Stato
OPERATIVO
Esperienza
- dic 2022 — gen 2025
Full Stack AI Engineer
Concept Recall
Ho lavorato sull’intero stack di Brarista, una piattaforma di fitting per reggiseni basata su AI per clienti e-commerce, e mi sono fatto carico della delivery del backend (Python, AWS Lambda, API Gateway) durante una carenza di personale nel team, imparando l’infrastruttura sul campo.
Ho individuato e risolto un bug di routing delle risposte multi-tenant nel backend di Brarista, che indirizzava silenziosamente gli utenti a un fallback non funzionante (“ricevi i risultati via email”) invece che alla loro effettiva raccomandazione di taglia; ho tracciato il problema tra frontend e backend e l’ho corretto senza riscrivere l’intero sistema circostante.
Ho trasformato il tool di fitting di Brarista in una libreria di componenti React riutilizzabile, adottata da due team interni per ulteriori storefront Shopify, e ho contribuito all’automazione CI/CD, alla copertura dei test E2E con Cypress e all’onboarding dei nuovi ingegneri tramite code review delle PR.
- mag 2021 — dic 2022
Freelance Full Stack Developer
Fiverr (Venditore di Livello 1)
Ho consegnato più di 30 progetti per oltre 15 clienti, tra integrazioni di API REST, sistemi di autenticazione, automazione backend e frontend responsive in React/Next.js con animazioni personalizzate.
Ho risolto problemi di JavaScript e CSS tra browser diversi per clienti di lungo periodo.
Ho mantenuto una valutazione costante di 5 stelle da parte dei clienti per tutto il periodo.
Progetti
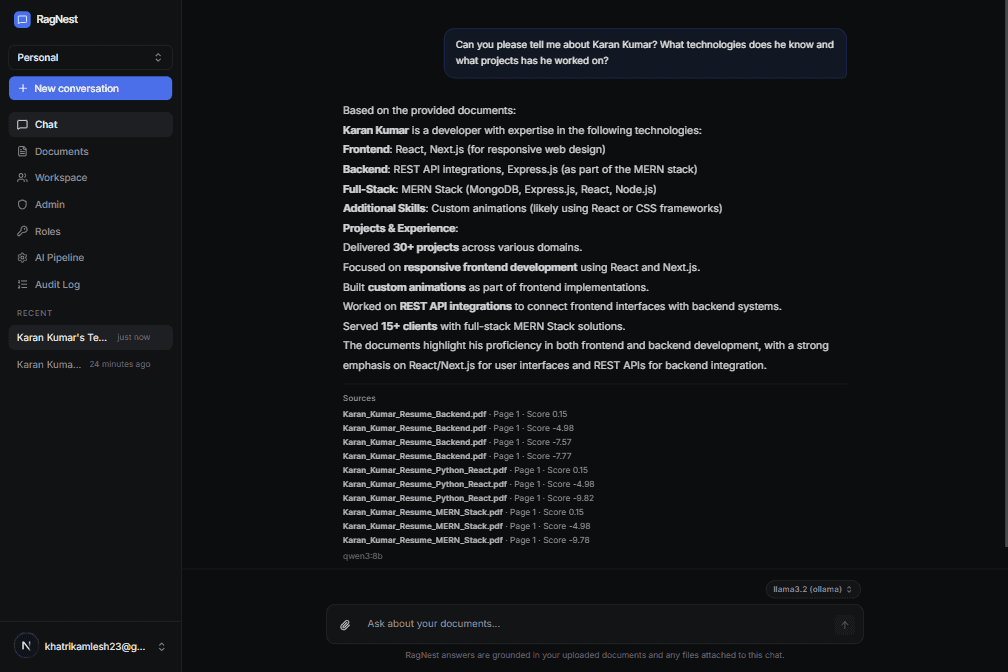
A multi-tenant retrieval-augmented generation platform where every model, every retrieval strategy, and every chunking rule is a database row an admin can change from a UI — not an environment variable that needs a redeploy. Redesigned from a flat settings table into a versioned pipeline registry, with rank-based RBAC that survived a real admin lockout.
Brarista AI Fitting Tool
An AI-powered size-calculation backend for an e-commerce bra-fitting platform, serving real-time predictions to live Shopify storefronts.
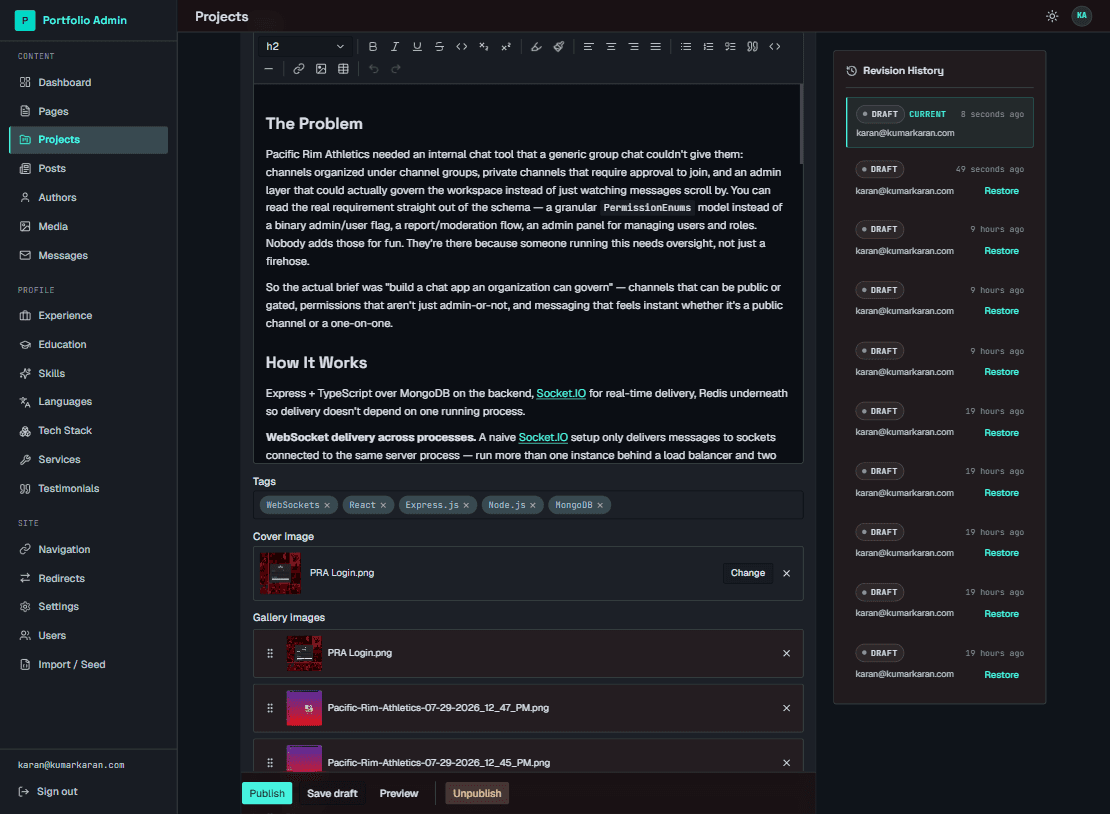
A Next.js portfolio with a self-built content system underneath it — draft/publish revisions, a section-based page composer, role-based admin access, and an admin-triggered JSON import pipeline for content — running on Vercel against a managed Postgres database.
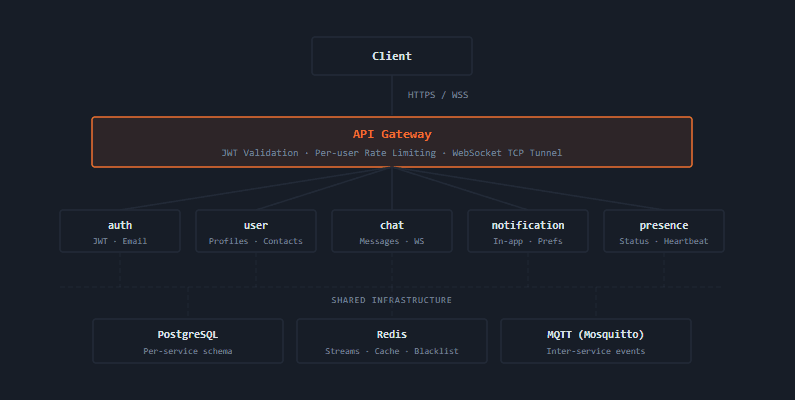
A production-grade real-time chat application built as six independent Go microservices. The architecture tackles WebSocket fan-out across instances via Redis Streams, JWT token rotation with race-condition safety, a three-layer blocking cache, and a raw-TCP WebSocket tunnel at the API gateway.
Competenze
Formazione
- set 2024 — ago 2026
Laurea Magistrale in Software: Science & Technology
Università degli Studi di Firenze (UNIFI) — Firenze, IT
Scambio Erasmus Nazionale (6 mesi) presso l’Università di Camerino (UNICAM), con corsi di software testing, sistemi multi-agente e process mining.
Corsi di Progettazione di Sistemi Distribuiti e di programmazione concorrente con Go, che mi hanno spinto a sviluppare GoChat in autonomia.
- ott 2018 — ott 2022
Laurea in Information Technology (BS)
Quaid-e-Awam University of Engineering, Science & Technology
Media (CGPA) 3,8/4,0, 4º della sua coorte di laureati.
Membro del Team Tecnico di TechnoMind-2k19, con l’organizzazione di oltre 14 competizioni tecniche.
In Sviluppo Ora
RagNest — il successore di RAG Pipeline from Scratch, pensato per la produzione. Quel progetto serviva a capire la retrieval-augmented generation costruendo a mano ogni passaggio; questo riprende la stessa pipeline e si chiede cosa serva perché regga a più di un utente: workspace multi-tenant, un registro delle pipeline versionato al posto di una configurazione hardcoded, RBAC completo e una vera interfaccia di amministrazione per gestire modelli e strategia di retrieval a runtime invece che nel file .env.